主题
线性回归、多项式回归与岭回归
方法速览
- 主要用途 预测连续值,或估计特征与平均响应的关系。
- 必要输入 连续目标及可在预测时取得的特征。
- 适用条件 线性或低阶特征能近似描述观测范围内的关系。高相关特征可考虑岭惩罚。
- 典型不适用情况 仅凭回归系数判断因果,或用高阶多项式远距离外推。
- 最低限度的验证方式 在同一留出集与均值基线比较 MAE 或 RMSE,并检查残差。
一分钟理解
假设你想根据温度预测奶茶销量。把每天的数据画成散点图:横轴温度,纵轴销量。线性回归做的事情只有一件——画一条直线,让所有点到这条直线的竖直距离(残差)的平方和最小。
- 这条直线就是「最小二乘直线」,它给出了「平均来说,温度每升 1℃,销量变化多少」的斜率估计。
- 为什么是「平方和最小」而不是「距离和最小」?因为平方惩罚大偏差更重,而且平方和求最小值有漂亮的一步到位的公式解。
- 学习率、梯度下降是求这条直线的另一种途径:闭式解一步算完,梯度下降一步步逼近。两者在本文的动画里都能看到。
下面的两个交互图可以先玩起来:左边拖动参数看残差怎么变,右边播放梯度下降看直线怎么一步步「走」到最优。
数学原理
符号定义
| 符号 | 含义 |
|---|---|
| 第 | |
| 样本数 | |
| 截距与斜率(待估参数) | |
| 模型预测值 | |
| 残差(观测值与预测值之差) | |
| 残差平方和(Error Sum of Squares) | |
| 总平方和(Total Sum of Squares) | |
| 决定系数:模型解释的目标方差比例 |
模型假设
最小二乘估计本身只需要「误差的平方和有界」,不要求误差服从正态分布。下面的假设服务于推断(置信区间、假设检验)与最优性结论,按重要性排序:
- 线性:平均响应与参数线性,
。注意:对 弯曲没关系,如 对参数仍是线性的。 - 独立:各样本误差不相关。时间序列、重复测量数据要特别检查这一点。
- 同方差:误差的方差与
无关。残差随预测值「喇叭形」散开就是异方差信号。 - 正态性:误差服从正态分布——只影响检验与预测区间的精确性,不影响参数估计的一致性。
最小二乘推导
目标是选择
对两个参数求偏导并令其为零:
第一个方程给出
几何直觉:把所有预测值写成
几何直觉与静态原理图
下图用三点数据
残差为
手算案例(与动画、算例同一组数据)
三点数据
- 斜率
,截距 ; - 预测值
,SSE ; , 。
五点演示数据
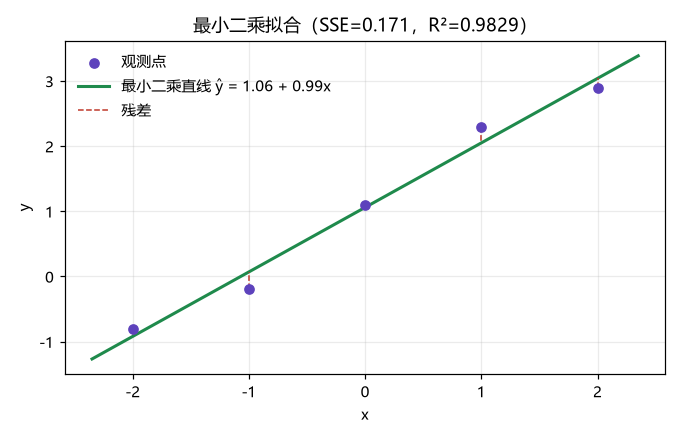
, ( , ); , , 。
岭回归
当特征之间高度相关时,
解析解与梯度下降
| 最小二乘闭式解 | 梯度下降 | |
|---|---|---|
| 原理 | 令偏导为零,解正规方程,一步到位 | 沿负梯度方向迭代逼近 |
| 适合 | 特征数不大、 | 数据量大、病态、或损失不可直接求导时 |
| 输出 | 精确解(浮点精度内) | 数值近似,受学习率与停止条件影响 |
| 本例 |
本文动画演示的是后者:教学演示的每一步都对应算法真实的一次参数更新——第
动态演示
手调参数实验
ŷ = 0.00 + 1.00·x
SSE = 5.79
R² = 0.42
继续调整:最小二乘解的 SSE 为 0.17
操作提示:拖动「斜率 β₁」「截距 β₀」两个滑块,观察直线转动、残差伸长缩短、SSE 与 R² 实时变化。点「对齐最小二乘解」把直线放到 SSE 最小的位置——你会发现任何微小偏移都会让 SSE 变大,这正是「最小」二字的含义。目标是最小化 SSE,而不是让残差看起来「平均为零」(那是最小二乘的自然结果,不是目标)。
梯度下降动画
θₖ₊₁ = θₖ − α·∇J(θₖ) = (—, —) = (0.0000, 0.0000) − 0.10·(—, —)
迭代 0θ = (0.0000, 0.0000)J = 3.1180‖∇J‖ = —收敛
初始参数 θ₀ = (0.0000, 0.0000),损失 J = 3.1180
1 / 88
更新公式(演示每一步都严格按它计算):
对五点数据,损失
| α | |1−αλ₁|, |1−αλ₂| | 实测结果 | | --- | --- | --- | | 0.1 | 0.8, 0.6 | 第 87 次迭代收敛(‖∇J‖ < 10⁻⁸),J → 0.0342 | | 0.5 | 0, 1 | 震荡:β₀ 一步到位,β₁ 在 0 与 1.98 之间往返,J 恒定 1.9944 | | 0.6 | 0.2, 1.4 | 发散:损失溢出为 ∞(动画中标记「发散」并截断显示) |
从 (0,0) 出发、α=0.1 的第一步:
Python 实践
完整代码
下面的代码与仓库 examples/linear_regression.py 逐字一致,可用 python examples/linear_regression.py 直接运行。脚本用三种独立途径(手写正规方程、numpy.linalg.lstsq、scikit-learn)互相验证,并复现上文的全部数值。
py
# -*- coding: utf-8 -*-
"""线性回归、岭回归与梯度下降 —— MathModel FAQ 可运行算例。

验证矩阵(三次独立计算互相核对,容差 1e-9):
  1. numpy 正规方程(手写)
  2. numpy.linalg.lstsq
  3. scikit-learn LinearRegression / Ridge

数据(全部固定,无随机性):
  三点手算例 x=(-1,0,1), y=(0,0,2)
    -> OLS slope=1, intercept=2/3, SSE=2/3, SST=8/3, R^2=0.75
    -> Ridge lambda=2: slope=1/2, intercept=2/3
  五点演示数据 x=(-2,-1,0,1,2), y=(-0.8,-0.2,1.1,2.3,2.9)
    -> OLS slope=0.99, intercept=1.06, SSE=0.171, R^2=0.982852...

梯度下降(MSE 损失,学习率 alpha):
  alpha=0.1  收敛(与闭式解一致,容差 1e-9)
  alpha=0.5  震荡(|1-alpha*lambda_max|=1,损失不再下降,梯度范数不趋零)
  alpha=0.6  发散(|1-alpha*lambda_max|=1.4>1,损失溢出为非有限值)

运行方式(本机实测:Python 3.14.8 + numpy 2.5.3 + scipy 1.18.1 +
scikit-learn 1.9.1 + matplotlib 3.11.2):
  python examples/linear_regression.py

输出:控制台数值表 + docs/public/examples/linear-regression-fit.png
     + docs/public/examples/linear-regression-gd.png
"""
import sys
import warnings
from pathlib import Path

# 使用非交互式绘图后端,将结果图保存为网页可引用的文件。
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
from numpy.linalg import lstsq
from sklearn.linear_model import LinearRegression, Ridge

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

ROOT = Path(__file__).resolve().parent.parent
OUT_DIR = ROOT / 'docs' / 'public' / 'examples'

# 三点用于手算,五点用于比较求解器和梯度下降;两组数据都固定。
THREE_X = np.array([-1.0, 0.0, 1.0])
THREE_Y = np.array([0.0, 0.0, 2.0])
DEMO_X = np.array([-2.0, -1.0, 0.0, 1.0, 2.0])
DEMO_Y = np.array([-0.8, -0.2, 1.1, 2.3, 2.9])


def normal_equations(x: np.ndarray, y: np.ndarray, lam: float = 0.0):
    """正规方程闭式解;lam>0 时为岭回归(截距不参与惩罚,1D 情形)。"""
    x_mean, y_mean = x.mean(), y.mean()
    # Sxx 是 x 的离差平方和,Sxy 是两列的离差乘积和。
    sxx = float(((x - x_mean) ** 2).sum())
    sxy = float(((x - x_mean) * (y - y_mean)).sum())
    # 岭惩罚增大斜率分母,截距仍由拟合线经过样本均值点确定。
    slope = sxy / (sxx + lam)
    intercept = y_mean - slope * x_mean
    return intercept, slope


def sse_of(x: np.ndarray, y: np.ndarray, b0: float, b1: float) -> float:
    return float(((y - (b0 + b1 * x)) ** 2).sum())


def gd_run(x: np.ndarray, y: np.ndarray, alpha: float, iters: int, tol: float = 1e-8):
    """MSE 梯度下降;返回 (b0, b1, losses, status)。"""
    n = len(x)
    b0, b1 = 0.0, 0.0
    losses = [sse_of(x, y, b0, b1) / n]
    status = 'max-iterations'
    for k in range(1, iters + 1):
        err = y - (b0 + b1 * x)
        # 误差定义为观测减拟合,对截距和斜率求导时都带负号。
        g0 = -2.0 * err.sum() / n
        g1 = -2.0 * float((err * x).sum()) / n
        b0 -= alpha * g0
        b1 -= alpha * g1
        loss = sse_of(x, y, b0, b1) / n
        losses.append(loss)
        if not np.isfinite(loss):
            status = 'diverged'
            break
        if np.hypot(g0, g1) < tol:
            status = 'converged'
            break
    else:
        # 迭代耗尽后比较最近十步的损失变化,作为本例震荡的诊断线索。
        tail = losses[max(0, len(losses) - 11):]
        if all(np.isfinite(tail)) and tail[-1] >= tail[0] * (1 - 1e-4):
            status = 'oscillating'
    return b0, b1, np.asarray(losses), status


def check_five_point():
    print('== 五点演示数据:三重独立计算 ==')
    b0_ne, b1_ne = normal_equations(DEMO_X, DEMO_Y)
    # 显式常数列配合两个系数;sklearn 的 LinearRegression 在内部拟合截距。
    (b0_ls, b1_ls), *_ = lstsq(np.column_stack([np.ones_like(DEMO_X), DEMO_X]), DEMO_Y, rcond=None)
    lr = LinearRegression().fit(DEMO_X.reshape(-1, 1), DEMO_Y)
    sse = sse_of(DEMO_X, DEMO_Y, b0_ne, b1_ne)
    # SST 是总变差,以全预测为 y 均值时的误差衡量拟合改善幅度。
    sst = float(((DEMO_Y - DEMO_Y.mean()) ** 2).sum())
    r2 = 1 - sse / sst
    assert abs(b0_ne - b0_ls) < 1e-9 and abs(b1_ne - b1_ls) < 1e-9, '正规方程与 lstsq 不一致'
    assert abs(b0_ne - lr.intercept_) < 1e-9 and abs(b1_ne - lr.coef_[0]) < 1e-9, '正规方程与 sklearn 不一致'
    print(f'  正规方程:     intercept={b0_ne:.12f}, slope={b1_ne:.12f}')
    print(f'  np.linalg:    intercept={b0_ls:.12f}, slope={b1_ls:.12f}')
    print(f'  sklearn OLS:  intercept={lr.intercept_:.12f}, slope={lr.coef_[0]:.12f}')
    print(f'  SSE={sse:.6f}  SST={sst:.6f}  R^2={r2:.6f}')
    print(f'  (四舍五入: slope=0.99, intercept=1.06, SSE=0.171, R^2≈0.982852)')
    return b0_ne, b1_ne, sse, r2


def check_three_point():
    print('== 三点手算例(全部分数)==')
    b0, b1 = normal_equations(THREE_X, THREE_Y)
    sse = sse_of(THREE_X, THREE_Y, b0, b1)
    sst = float(((THREE_Y - THREE_Y.mean()) ** 2).sum())
    r2 = 1 - sse / sst
    print(f'  OLS:   slope={b1:.12f} (期望 1), intercept={b0:.12f} (期望 2/3)')
    print(f'  SSE={sse:.12f} (期望 2/3)  SST={sst:.12f} (期望 8/3)  R^2={r2:.12f} (期望 0.75)')
    assert abs(b1 - 1.0) < 1e-12 and abs(b0 - 2 / 3) < 1e-12
    assert abs(sse - 2 / 3) < 1e-12 and abs(sst - 8 / 3) < 1e-12 and abs(r2 - 0.75) < 1e-12
    b0r, b1r = normal_equations(THREE_X, THREE_Y, lam=2.0)
    # sklearn 接收二维特征表;这里 reshape 成“样本数 × 1”。
    ridge = Ridge(alpha=2.0).fit(THREE_X.reshape(-1, 1), THREE_Y)
    print(f'  岭回归 lambda=2: slope={b1r:.12f} (期望 1/2), intercept={b0r:.12f} (期望 2/3)')
    print(f'  sklearn Ridge:   slope={ridge.coef_[0]:.12f}, intercept={ridge.intercept_:.12f}')
    assert abs(b1r - 0.5) < 1e-12 and abs(b0r - 2 / 3) < 1e-12
    assert abs(ridge.coef_[0] - 0.5) < 1e-9 and abs(ridge.intercept_ - 2 / 3) < 1e-9


def check_gd(b0_target: float, b1_target: float):
    print('== 梯度下降(起点 (0,0),MSE 损失)==')
    n = len(DEMO_X)
    print('  理论特征值 lambda(Hessian) = (2, 2*E[x^2]) = (2, 4),临界学习率 2/4 = 0.5')
    # alpha=0.6 必然数值溢出为 inf,这是「发散」的预期表现,抑制对应警告。
    with warnings.catch_warnings(), np.errstate(over='ignore', invalid='ignore'):
        warnings.simplefilter('ignore', RuntimeWarning)
        for alpha in (0.1, 0.5, 0.6):
            b0, b1, losses, status = gd_run(DEMO_X, DEMO_Y, alpha, iters=2000)
            gnorm_final = 'n/a'
            if status == 'converged':
                gnorm_final = '0'
                assert abs(b0 - b0_target) < 1e-6 and abs(b1 - b1_target) < 1e-6, \
                    f'alpha={alpha}: 收敛值偏离闭式解(容差 1e-6,与前端 TS 引擎一致)'
            elif status == 'oscillating':
                # b0 一步收敛、b1 在 0 与 1.98 之间往返;梯度范数恒定约 3.96
                err = DEMO_Y - (b0 + b1 * DEMO_X)
                g0 = -2.0 * err.sum() / n
                g1 = -2.0 * float((err * DEMO_X).sum()) / n
                gnorm_final = f'{np.hypot(g0, g1):.4f}'
                assert np.hypot(g0, g1) > 1.0, f'alpha={alpha}: 震荡判定错误'
            print(f'  alpha={alpha}: status={status}, 末次 b0={b0:.6f}, b1={b1:.6f}, '
                  f'末次 loss={losses[-1] if np.isfinite(losses[-1]) else "Infinity"}, '
                  f'末次梯度范数={gnorm_final}')
            if alpha == 0.6:
                assert status == 'diverged' and not np.isfinite(losses[-1]), 'alpha=0.6 应发散'
            if alpha == 0.5:
                assert status == 'oscillating', 'alpha=0.5 应震荡'
    # 收敛极限再验证:更严梯度判据 + 固定 5000 次迭代直接比较
    b0, b1, _, status = gd_run(DEMO_X, DEMO_Y, 0.1, iters=5000, tol=1e-12)
    assert status == 'converged'
    print(f'  alpha=0.1 固定 5000 次迭代后: b0={b0:.12f}, b1={b1:.12f},与闭式解偏差 < 1e-12: '
          f'{abs(b0 - b0_target) < 1e-12 and abs(b1 - b1_target) < 1e-12}')
    assert abs(b0 - b0_target) < 1e-12 and abs(b1 - b1_target) < 1e-12


def make_figures(b0: float, b1: float, sse: float, r2: float):
    OUT_DIR.mkdir(parents=True, exist_ok=True)

    fig, ax = plt.subplots(figsize=(6.2, 4.0), dpi=110)
    ax.scatter(DEMO_X, DEMO_Y, color='#5d42bc', zorder=3, label='观测点')
    xs = np.linspace(DEMO_X.min() - 0.35, DEMO_X.max() + 0.35, 60)
    yhat = b0 + b1 * xs
    ax.plot(xs, yhat, color='#1f8a4c', lw=2, label=f'最小二乘直线 ŷ = {b0:.2f} + {b1:.2f}x')
    # 画出 y 方向的残差;竖线长度的平方就是该样本对 SSE 的贡献。
    for x, y in zip(DEMO_X, DEMO_Y):
        ax.plot([x, x], [y, b0 + b1 * x], color='#c0392b', lw=1, ls='--', zorder=2)
    ax.plot([], [], color='#c0392b', lw=1, ls='--', label='残差')
    ax.set_xlabel('x')
    ax.set_ylabel('y')
    ax.set_title(f'最小二乘拟合(SSE={sse:.3f},R²={r2:.4f})')
    ax.legend(frameon=False)
    ax.grid(alpha=0.25)
    fig.tight_layout()
    fig.savefig(OUT_DIR / 'linear-regression-fit.png')
    plt.close(fig)

    fig, axes = plt.subplots(1, 3, figsize=(11.5, 3.4), dpi=110)
    with warnings.catch_warnings(), np.errstate(over='ignore', invalid='ignore'):
        warnings.simplefilter('ignore', RuntimeWarning)
        for ax, alpha in zip(axes, (0.1, 0.5, 0.6)):
            _, _, losses, status = gd_run(DEMO_X, DEMO_Y, alpha, iters=2000)
            # 对数轴上只画有限损失,虚线表示闭式解给出的最小 MSE。
            finite = losses[np.isfinite(losses)]
            ax.plot(np.arange(len(finite)), finite, color='#5d42bc', lw=1.5)
            ax.axhline(sse / len(DEMO_X), color='#1f8a4c', lw=1, ls='--', label='J*')
            ax.set_title(f'α = {alpha}({status})')
            ax.set_xlabel('迭代次数')
            ax.set_ylabel('损失 J')
            ax.set_yscale('log')
            ax.grid(alpha=0.25)
            ax.legend(frameon=False)
    fig.tight_layout()
    fig.savefig(OUT_DIR / 'linear-regression-gd.png')
    plt.close(fig)
    print(f'== 绘图已保存到 {OUT_DIR} ==')


def main() -> None:
    print('== 环境 ==')
    print(f'  Python {sys.version.split()[0]}')
    import numpy, scipy, sklearn, matplotlib as _mpl
    print(f'  numpy {numpy.__version__}, scipy {scipy.__version__}, '
          f'scikit-learn {sklearn.__version__}, matplotlib {_mpl.__version__}')
    check_three_point()
    b0, b1, sse, r2 = check_five_point()
    check_gd(b0, b1)
    make_figures(b0, b1, sse, r2)
    print('== 全部断言通过 ==')


if __name__ == '__main__':
    main()
运行方式
bash
cd mathmodel-faq
pip install -r examples/requirements.txt   # numpy / scipy / scikit-learn / matplotlib
python examples/linear_regression.py
依赖列表见仓库 examples/requirements.txt(numpy / scipy / scikit-learn / matplotlib)。本机实测环境:Python 3.14.8、numpy 2.5.3、scipy 1.18.1、scikit-learn 1.9.1、matplotlib 3.11.2。脚本不联网、不用付费 API;所有断言失败时脚本会以非零退出码退出。
输出结果(本机实际运行)
text
== 环境 ==
  Python 3.14.8
  numpy 2.5.3, scipy 1.18.1, scikit-learn 1.9.1, matplotlib 3.11.2
== 三点手算例(全部分数)==
  OLS:   slope=1.000000000000 (期望 1), intercept=0.666666666667 (期望 2/3)
  SSE=0.666666666667 (期望 2/3)  SST=2.666666666667 (期望 8/3)  R^2=0.750000000000 (期望 0.75)
  岭回归 lambda=2: slope=0.500000000000 (期望 1/2), intercept=0.666666666667 (期望 2/3)
  sklearn Ridge:   slope=0.500000000000, intercept=0.666666666667
== 五点演示数据:三重独立计算 ==
  正规方程:     intercept=1.060000000000, slope=0.990000000000
  np.linalg:    intercept=1.060000000000, slope=0.990000000000
  sklearn OLS:  intercept=1.060000000000, slope=0.990000000000
  SSE=0.171000  SST=9.972000  R^2=0.982852
== 梯度下降(起点 (0,0),MSE 损失)==
  理论特征值 lambda(Hessian) = (2, 2*E[x^2]) = (2, 4),临界学习率 2/4 = 0.5
  alpha=0.1: status=converged, 末次 b0=1.060000, b1=0.990000, 末次 loss=0.034199999999999994, 末次梯度范数=0
  alpha=0.5: status=oscillating, 末次 b0=1.060000, b1=0.000000, 末次 loss=1.9943999999999982, 末次梯度范数=3.9600
  alpha=0.6: status=diverged, 末次 b0=…(巨大的发散值)…, 末次 loss=Infinity
  alpha=0.1 固定 5000 次迭代后: b0=1.060000000000, b1=0.990000000000,与闭式解偏差 < 1e-12: True
== 绘图已保存到 …docs\public\examples ==
== 全部断言通过 ==
拟合图
关键参数
| 参数 | 含义 | 本算例取值与效果 |
|---|---|---|
| λ(岭) | 惩罚强度,越大斜率收缩越强 | λ=2 时斜率 1 → 0.5 |
| α(学习率) | 梯度下降步长 | 0.1 收敛 / 0.5 震荡 / 0.6 发散 |
| 最大迭代次数 | 迭代上限,不决定收敛精度 | 收敛时以梯度范数 < 10⁻⁸ 提前停止 |
| 多项式阶数 | 特征展开程度 | 本算例为 1 阶;升阶前先画残差图 |
模型验证
- 划分训练集/验证集/测试集(数据划分),阶数与 λ 只在验证集上选择。
- 报告均值基线的 MAE/RMSE 作为对照——如果直线打不过「一律预测均值」,模型没有价值。
- 检查残差图:残差对
、对 不应有系统形状;喇叭形散开提示异方差。 - 报告
时同时看 SSE 的量纲含义(回归指标如何解读)。 - 换不同随机划分重跑,系数与误差应稳定;波动剧烈说明样本太少或特征共线。
常见错误
- 用全量数据选多项式阶数再报测试成绩:验证集参与了模型选择,测试成绩被高估,属于数据泄漏(未来信息泄漏)。
- 不标准化就套岭惩罚:量纲大的特征被不成比例地收缩。
- 只看 R²:R² 不度量因果、不度量外推能力,也随噪声水平变化。
- 远距离外推:高阶多项式在观测范围外可以任意发散,外推前画出实际使用区间的预测曲线。
- 学习率拍脑袋:α 超过
必发散,接近临界值会震荡——先估计 Hessian 特征值再选 α。
特殊情况与反例
| 情况 | 症状 | 诊断与处理 |
|---|---|---|
| x 全为常数(零方差) | 斜率公式分母 | 特征无变异就无法估计斜率;删除该特征或收集更多变异样本(常数列与零方差) |
| 特征高度相关 | 系数随样本剧烈波动、符号反复 | 改用岭回归,或合并/删除相关特征(高度相关的特征) |
| 异方差 | 残差随预测值喇叭形散开 | 变换响应(对数/Box-Cox)或加权最小二乘 |
| 少数异常点主导 | 删掉一个点直线大幅摆动 | 复核数据来源;稳健回归(Huber)作对照(离群点) |
| α 过大 | 梯度下降损失爆炸(本文动画可复现) | 减小 α 或先对特征标准化(特征缩放、模型不收敛) |
| 高阶多项式过拟合 | 训练误差低、测试误差高 | 降低阶数或加强正则化(识别和修正过拟合) |
参考资料与 FAQ
- scikit-learn 用户指南 · Linear Models(OLS 与 Ridge)(官方文档,含岭回归的数学与求解器说明)
- James, Witten, Hastie, Tibshirani, An Introduction to Statistical Learning, Springer, 2021 —— 第 3 章线性回归的入门级讲解,官网免费 PDF
- Hastie, Tibshirani, Friedman, The Elements of Statistical Learning, 2nd ed., Springer, 2009 —— 第 3 章线性方法与最小二乘的矩阵推导,官网免费 PDF
- Nocedal & Wright, Numerical Optimization, 2nd ed., Springer, 2006, DOI: 10.1007/978-0-387-40065-5 —— 梯度下降收敛条件与学习率上界(第 2–3 章)
高频问题:
- 「为什么训练精度高,预测却很差?」→ 识别和修正过拟合
- 「梯度下降不收敛 / loss 变成 NaN?」→ 模型不收敛怎么办 与 NaN loss 排查
- 「MAE、RMSE、R² 各看什么?」→ 回归指标如何解读
- 「需要标准化吗?」→ 特征缩放
双语言实验
从一条直线到矩阵
假设有五天的设备运行时长
常数列把截距纳入同一次求解。最优时残差与设计矩阵的两列正交,即
计算、制图与检验
Python 使用 NumPy、Matplotlib,下载后运行 python mmf_ols.py。使用 MATLAB 时把文件存到当前文件夹,在命令行输入 mmf_ols。MATLAB 基础版即可。 Python 的 lstsq 与 MATLAB 的 design \ y 都用矩形设计矩阵求最小二乘,与由中心化公式计算的结果交叉核对。两份脚本只用前五天拟合,把 6 小时和 7 小时的额外观测留给检验。预测为 12.3、14.2 kWh,观测为 12、15 kWh,所以留出 MAE 为
五个点拟合一条含截距的直线。设计矩阵的两列分别是特征和常数;检查斜率 0.60、截距 2.20、平方残差和 2.40,以及 x=6 的预测 5.80。
最简版依赖 Python:NumPy。MATLAB:基础功能,无需额外工具箱。
在源码所在目录运行 python mmf_min_ols.py
py
下载当前源码import json
import numpy as np
# 每行是一项观测;设计矩阵第 2 列固定为 1,让模型学习截距。
x = np.arange(1.0, 6.0)
y = np.array([2, 4, 5, 4, 5])
design = np.column_stack((x, np.ones_like(x)))
# 求使 ||Xθ-y||² 最小的 θ,返回元组的第一项存放斜率和截距。
slope, intercept = np.linalg.lstsq(design, y, rcond=None)[0]
sse = float(np.sum((design @ [slope, intercept] - y) ** 2))
prediction = float(6 * slope + intercept)
assert np.allclose([slope, intercept, sse, prediction], [.6, 2.2, 2.4, 5.8])
result = {"coefficients": [float(slope), float(intercept)], "sse": sse, "prediction": prediction}
print("LAB_RESULT " + json.dumps(result, ensure_ascii=False))残差图每个点与零线的差是有符号误差。如果高时长普遍低估,先检查拟合范围和模型形式。斜率来自观测关系,设备的额定功率和工况都可能同时影响时长、用电量。相关与因果 FAQ
练习与解析
将各天时长全部加 10 小时但保持用电量不变。新均值也加 10,所有