主题
蒙特卡洛方法
方法速览
- 主要用途 用随机采样与统计平均估计确定性量(如 π、积分、期望),或模拟含随机性的过程。
- 必要输入 可编程的随机数发生器、采样数量 n、能把目标量写成期望的无偏/近似统计量。
- 适用条件 目标量能写成随机变量的期望(方差有界),采样成本可接受,且随机数质量可靠。
- 典型不适用情况 精度要求极高却无法承受 O(1/√n) 收敛所需的样本量,或需要确定性证明而非概率保证。
- 最低限度的验证方式 固定 seed 重跑得到逐位一致的结果,并用解析值(如 π)或独立方法交叉核对,确认区间覆盖真实值。
快速回答
蒙特卡洛方法的本质,是把「求一个确定量的值」转化为「估计一个随机变量的期望」,再用大量随机采样取平均来逼近。以估 π 为例:在
适用条件:目标量能写成期望、方差有界、随机数质量可靠。注意事项:必须固定 seed 才能复现;
从零理解
想象一个边长 1 的正方形里嵌着一个
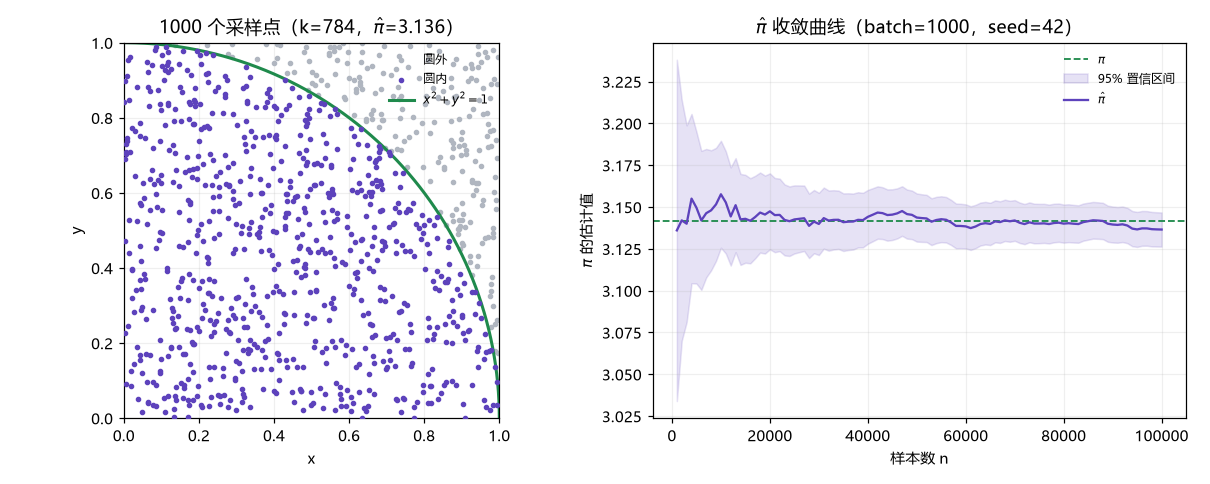
下图(本文「动态实验」动画的左图)画的就是这个场景:单位正方形里随机点均匀铺开,圆内点(品牌色)与圆外点(灰色)的比例约为
关键在「均匀」二字:点必须在
数学原理
符号定义
| 符号 | 含义 |
|---|---|
| 采样点数 | |
| 第 | |
| 指示变量:点落在 | |
| 落在圆内的点数 | |
| 单个点落在圆内的概率( | |
| 圆内比例的估计 | |
| 标准误差(估计量的标准差) |
π 估计公式推导
- 单个点
落在 圆内的概率等于面积之比:
每个点是否落在圆内是独立的
试验,因此 ,期望 。 于是
满足
标准误差与 95% 区间
估计量的标准差即标准误差:
由中心极限定理,
区间的含义是「按这套采样流程重复多次,约 95% 的区间会覆盖真实
收敛阶 O(1/√n)
因为
成立条件与反例
- 伪随机序列周期:mulberry32 的状态只有 32 位(周期约
)。若 接近或超过周期,序列开始重复,点不再「独立均匀」,估计会系统性偏置。本算例 是安全的,但换用周期更短的自制随机数就会踩坑。 - 维度灾难:在高维
中估计某几何体的体积时,随着 增大,「落在有贡献区域」的比例指数级趋近于 0,简单随机采样的方差爆炸,需要指数级样本才能维持同一精度。诊断信号是 趋近 0、SE 相对均值异常大;替代路径是重要性采样或低差异序列。这说明蒙特卡洛并非「越高维越好用」,简单随机采样在高维有明确失效边界。
动态实验
π̂ ≈ 3.1360
95% 置信区间:[3.0340, 3.2380]
样本 1000圆内 k = 784|π̂ − π| = 0.0056
前 1000 个点:k=784,π̂=3.1360,区间 [3.0340, 3.2380]。随机点开始覆盖正方形。
1 / 10
参数说明:
- 总样本数 n:1000 / 10000 / 100000,越大估计越接近
。 - 每批大小:100 / 500 / 1000 / 2000,只影响动画帧的粒度,不改变末帧结果。
- seed:42 / 7 / 1,均为固定种子;改参数会重新采样并回到第 0 帧。
动画每一帧都是真实采样的一批:帧内 mulberry32(seed) 的逐点抽样(先取 estimatePi(n, seed) 完全一致。散点图最多显示前 2000 个点,估计与区间始终使用全部
| n | k | π̂ | SE | 95% CI |
|---|---|---|---|---|
| 1000 | 784 | 3.13600 | 0.05205290 | [3.03398, 3.23802] |
| 10000 | 7894 | 3.15760 | 0.01630939 | [3.12563, 3.18957] |
| 100000 | 78413 | 3.13652 | 0.00520415 | [3.12632, 3.14672] |
代码实践
完整代码
下面直接展示仓库中的 examples/monte_carlo.py,可用 python examples/monte_carlo.py 直接运行。脚本用与前端 TS 引擎逐位一致的 mulberry32,固定 seed 断言区间覆盖
py
# -*- coding: utf-8 -*-
"""蒙特卡洛方法估计 π —— MathModel FAQ 可运行算例。

随机撒点估计 π:在 [0,1]^2 内撒 n 个 (x, y) 点,统计落在 1/4 单位圆
(x^2 + y^2 <= 1)内的点数 k,估计 π^ = 4k/n。

确定性 RNG:本文件 mulberry32 与前端 TS 引擎
(docs/.vitepress/theme/math/monteCarlo.ts)逐位一致,同 seed 同 k;
不使用系统随机,保证跨语言可复现。seed=42 时:
  n=1000   -> k=784,  π^=3.136
  n=10000  -> k=7894, π^=3.1576
  n=100000 -> k=78413,π^=3.13652
(与 tests/monte-carlo.test.ts 钉死的 k 值逐位一致。)

95% 置信区间:SE = 4*sqrt(p^(1-p^)/n),p^ = π^/4;区间 = π^ ± 1.96·SE。
固定 seed 下断言 π 落在区间内(这是确定性断言,等价于 |π^-π| < 1.96·SE)。

运行方式(本机实测:Python 3.14.8 + numpy 2.5.3 + matplotlib 3.11.2):
  python examples/monte_carlo.py

输出:控制台数值表 + docs/public/examples/monte-carlo-demo.png
     (左:1000 个采样点与 1/4 圆;右:π^ 收敛曲线与 95% 区间带)。
"""
import sys
import math
from pathlib import Path

# 使用无窗口的 Agg 后端,把命中散点与估计曲线输出成 PNG。
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

ROOT = Path(__file__).resolve().parent.parent
OUT_DIR = ROOT / 'docs' / 'public' / 'examples'

MASK32 = 0xFFFFFFFF
PI = math.pi


def _to_i32(u: int) -> int:
    """把 [0, 2^32) 的位型转成有符号 32 位整数。"""
    return u - 0x100000000 if u >= 0x80000000 else u


def mulberry32(seed: int):
    """确定性 RNG,与前端 TS 引擎逐位一致。返回闭包,每次调用输出 [0,1)。"""
    a = seed & MASK32

    def next_() -> float:
        # 保留同一状态,并将中间值限制在 32 位,以复现前端的随机序列。
        nonlocal a
        a = (a + 0x6D2B79F5) & MASK32
        t = a
        s1 = t ^ (t >> 15)
        s2 = t | 1
        t2 = (_to_i32(s1) * _to_i32(s2)) & MASK32
        s3 = t2 ^ (t2 >> 7)
        s4 = t2 | 61
        m2 = (_to_i32(s3) * _to_i32(s4)) & MASK32
        t3 = t2 ^ ((_to_i32(t2) + _to_i32(m2)) & MASK32)
        r = (t3 ^ (t3 >> 14)) & MASK32
        return r / 4294967296.0

    return next_


def estimate_pi(n: int, seed: int):
    """撒 n 个点,返回 (k, estimate)。"""
    rng = mulberry32(seed)
    k = 0
    for _ in range(n):
        x = rng()
        y = rng()
        # 只需比较到原点的距离平方,省去开方。
        if x * x + y * y <= 1.0:
            k += 1
    return k, 4.0 * k / n


def standard_error(estimate: float, n: int) -> float:
    # 单点命中为 Bernoulli 指标,均值方差是 p*(1-p)/n;换到 π 尺度时标准误乘 4。
    p = estimate / 4.0
    return 4.0 * math.sqrt(p * (1.0 - p) / n)


def confidence_interval(estimate: float, n: int):
    # 这是教学用的正态近似。命中率接近 0 或 1 或样本很少时可改用 Wilson 区间。
    se = standard_error(estimate, n)
    return estimate - 1.96 * se, estimate + 1.96 * se


def run_table():
    print('== 蒙特卡洛估计 π(seed=42,mulberry32)==')
    expected_k = {1000: 784, 10000: 7894, 100000: 78413}
    print(f'{"n":>7} {"k":>6} {"π^":>10} {"SE":>11} {"95% CI 下界":>13} {"95% CI 上界":>13}')
    results = {}
    for n in (1000, 10000, 100000):
        # 每次从同一个种子开始,因此是同一随机序列的不同长度前缀。
        k, est = estimate_pi(n, 42)
        se = standard_error(est, n)
        lo, hi = confidence_interval(est, n)
        assert k == expected_k[n], f'n={n}: k={k} 与前端 TS 引擎不一致(期望 {expected_k[n]})'
        assert lo < PI < hi, f'n={n}: 95% 置信区间未覆盖 π([{lo:.6f}, {hi:.6f}])'
        assert abs(est - PI) < 1.96 * se, f'n={n}: |π^-π| 超过 1.96·SE'
        print(f'{n:>7} {k:>6} {est:>10.5f} {se:>11.8f} {lo:>13.8f} {hi:>13.8f}')
        results[n] = (k, est, se, lo, hi)
    return results


def make_figure():
    OUT_DIR.mkdir(parents=True, exist_ok=True)

    fig, (ax_scatter, ax_conv) = plt.subplots(1, 2, figsize=(11.0, 4.4), dpi=110)

    # 左图颜色区分命中,等比例坐标维持四分之一圆的几何形状。
    rng = mulberry32(42)
    n_scatter = 1000
    xs = np.empty(n_scatter)
    ys = np.empty(n_scatter)
    for i in range(n_scatter):
        xs[i] = rng()
        ys[i] = rng()
    inside = xs * xs + ys * ys <= 1.0
    ax_scatter.scatter(xs[~inside], ys[~inside], s=7, color='#b0b6c0', label='圆外', zorder=2)
    ax_scatter.scatter(xs[inside], ys[inside], s=7, color='#5d42bc', label='圆内', zorder=3)
    theta = np.linspace(0.0, PI / 2, 200)
    ax_scatter.plot(np.cos(theta), np.sin(theta), color='#1f8a4c', lw=2, label=r'$x^2+y^2=1$')
    ax_scatter.set_xlim(0, 1)
    ax_scatter.set_ylim(0, 1)
    ax_scatter.set_aspect('equal')
    ax_scatter.set_xlabel('x')
    ax_scatter.set_ylabel('y')
    k, est = estimate_pi(1000, 42)
    ax_scatter.set_title(f'{n_scatter} 个采样点(k={k},' + r'$\hat{\pi}$' + f'={est:.3f})')
    ax_scatter.legend(frameon=False, loc='upper right', fontsize=8)
    ax_scatter.grid(alpha=0.2)

    # 右图每新增一批就更新累计估计。各点有关联,色带表示逐预算的区间。
    n_conv = 100000
    batch = 1000
    rng2 = mulberry32(42)
    pts_total = []
    inside_total = 0
    ests = []
    los = []
    his = []
    step = 0
    while step < n_conv:
        take = min(batch, n_conv - step)
        for _ in range(take):
            if rng2() ** 2 + rng2() ** 2 <= 1.0:
                inside_total += 1
        step += take
        est_now = 4.0 * inside_total / step
        se_now = standard_error(est_now, step)
        lo_now, hi_now = confidence_interval(est_now, step)
        pts_total.append(step)
        ests.append(est_now)
        los.append(lo_now)
        his.append(hi_now)
    ax_conv.axhline(PI, color='#1f8a4c', lw=1.2, ls='--', label=r'$\pi$')
    ax_conv.fill_between(pts_total, los, his, color='#5d42bc', alpha=0.15, label='95% 置信区间')
    ax_conv.plot(pts_total, ests, color='#5d42bc', lw=1.5, label=r'$\hat{\pi}$')
    ax_conv.set_xlabel('样本数 n')
    ax_conv.set_ylabel(r'$\pi$ 的估计值')
    ax_conv.set_title(r'$\hat{\pi}$ 收敛曲线(batch=1000,seed=42)')
    ax_conv.legend(frameon=False, fontsize=8)
    ax_conv.grid(alpha=0.2)

    fig.tight_layout()
    out = OUT_DIR / 'monte-carlo-demo.png'
    fig.savefig(out)
    plt.close(fig)
    print(f'== 绘图已保存到 {out} ==')


def main() -> None:
    print('== 环境 ==')
    print(f'  Python {sys.version.split()[0]}')
    import numpy as _np, matplotlib as _mpl
    print(f'  numpy {_np.__version__}, matplotlib {_mpl.__version__}')
    run_table()
    make_figure()
    print('== 全部断言通过 ==')


if __name__ == '__main__':
    main()
运行方式
bash
cd mathmodel-faq
pip install numpy matplotlib      # 本算例仅需 numpy + matplotlib
python examples/monte_carlo.py
本机实测环境:Python 3.14.8、numpy 2.5.3、matplotlib 3.11.2。脚本不联网、不使用系统随机;所有断言失败时脚本以非零退出码退出。
输出结果(本机实际运行)
text
== 环境 ==
  Python 3.14.8
  numpy 2.5.3, matplotlib 3.11.2
== 蒙特卡洛估计 π(seed=42,mulberry32)==
      n      k         π^          SE     95% CI 下界     95% CI 上界
   1000    784    3.13600  0.05205290    3.03397632    3.23802368
  10000   7894    3.15760  0.01630939    3.12563359    3.18956641
 100000  78413    3.13652  0.00520415    3.12631986    3.14672014
== 绘图已保存到 …docs\public\examples\monte-carlo-demo.png ==
== 全部断言通过 ==
结果图
关键参数
| 参数 | 含义 | 本算例取值与效果 |
|---|---|---|
| n | 采样点数 | 1000 / 10000 / 100000,n 增到 100 倍 SE 降到约 1/10 |
| seed | 随机种子 | 42(默认)/ 7 / 1,固定 seed 结果逐位可复现 |
| 1.96 | 95% 正态分位数 | 区间 = π̂ ± 1.96·SE |
| batchSize | 动画每批点数 | 100 / 500 / 1000 / 2000,只影响帧粒度,不影响末帧结果 |
常见错误
- 不设 seed:每次运行结果都不同,无法复现、无法与他人或前次运行核对。
- 用系统随机不可复现:系统
random无法跨语言、跨运行逐位一致;教学与验证应使用确定性 RNG(如本算例的 mulberry32)。 - 把模拟结果当精确值:
是随机变量,单次与 的偏差是抽样噪声,不是「算法错了」;必须附 SE 与置信区间,并与解析值或独立方法交叉验证。
专业速查
| 项目 | 内容 |
|---|---|
| 假设 | 样本独立同分布;目标量可写成期望;方差有界;RNG 质量足够 |
| 参数 | n(样本量)、seed(随机种子)、统计量形式 |
| 复杂度 | 每次采样 O(1),总 O(n);内存 O(1)(不存点)或 O(n)(存点) |
| 优点 | 简单通用、低维下不依赖维度、易并行、误差可用 SE/CI 估计 |
| 缺点 | 收敛慢 O(1/√n);高维时简单采样方差爆炸;依赖 RNG 质量 |
| 评价指标 | SE、95% CI、与解析值/独立方法的偏差、区间覆盖真实值 |
| 相关 FAQ | 代码能够运行,但结果无法复现怎么办?、如何判断一个模型是否可靠? |
双语言实验
面积比例可以换成一个个命中指示值
两份代码从同一个明确的小型伪随机生成器取前 python mmf_monte_carlo.py。MATLAB 基础版把文件放在当前文件夹并输入 mmf_monte_carlo。分别使用布尔索引查看命中点,用累积和读取四个样本预算的命中次数。
固定 8 个坐标,逐点判断是否落在四分之一单位圆内。6 次命中给面积比 0.75、π 估计 3。正式蒙特卡洛需独立均匀抽样及误差评估。
最简版依赖 Python:无第三方依赖。MATLAB:基础功能,无需额外工具箱。
在源码所在目录运行 python mmf_min_monte_carlo.py
py
下载当前源码import json
points = [(0.1, 0.2), (0.5, 0.5), (0.2, 0.9), (0.9, 0.1),
(0.8, 0.7), (0.4, 0.7), (0.95, 0.95), (0.7, 0.3)]
# 坐标在单位正方形内,x²+y²≤1 的点也在其四分之一单位圆内。
hits = sum(x * x + y * y <= 1 for x, y in points)
ratio = hits / len(points)
# 该四分之一圆的面积为 π/4,乘以 4 还原 π。
estimate = 4 * ratio
assert hits == 6 and estimate == 3
result = {"hits": hits, "ratio": ratio, "pi_estimate": estimate}
print("LAB_RESULT " + json.dumps(result, ensure_ascii=False))代码采用命中率的 Wilson 区间再乘
练习与解析
把最大预算从 2000 调到 8000,保持前缀取样规则。区间通常明显变窄,但点估计到真值的距离不保证单次变小。若要评价方法精度,应比较多次重复的误差分布。