主题
粒子群优化 PSO
方法速览
- 主要用途 在连续、多峰、不可导或黑箱目标中寻找近似全局最优(本页以最大化为例,最小化只需对目标取负)。
- 必要输入 目标函数、可行域边界、种群规模(粒子数)、迭代次数、参数
/ / 与速度上限,以及一个可复现的随机数发生器(固定 seed)。 - 适用条件 变量为连续、可行域是矩形盒约束(每维一个区间),且允许返回「足够好」的近似解而非严格最优证明。
- 典型不适用情况 需要严格全局最优证明、目标函数评估极其昂贵,或变量是离散组合(需先设计合适的编码与离散更新规则)。
- 最低限度的验证方式 用独立网格搜索或枚举给出参考最优,固定 seed 复现,多 seed 统计 gbest 分布,并观察收敛曲线是否停滞。
快速回答
粒子群优化(Particle Swarm Optimization,PSO)是受鸟群、鱼群觅食行为启发的群体智能优化算法。它维护一群「粒子」——每个粒子是一个候选解,携带位置
即「按惯性继续原方向 + 往自己历史最好
它和模拟退火的关键区别在于跳出局部最优的机制不同:模拟退火靠「以概率接受劣解」翻越山谷,PSO 靠「群体共享记忆 + 惯性飞行」让粒子群越过局部峰。二者都是启发式,返回近似解而非严格全局最优。
从零理解
想象一群人在浓雾中的山地上分头寻找最高点,互相可以喊话。每个人:
- 随机站在一个位置(粒子 = 候选解);
- 每走一步都记住「自己去过的最高点」——这是个体记忆 pbest;
- 大家随时通报「全队目前找到的最高点」——这是群体记忆 gbest;
- 下一步往哪走?三个方向的合力:
- 惯性:继续按原来的速度方向走(保留探索的冲劲);
- 自我认知:往自己的 pbest 方向走一点;
- 社会认知:往全队的 gbest 方向走一点。
逐项「翻译」成优化语言:
| 鸟群觅食 | 优化中的对应 |
|---|---|
| 一只鸟的位置 | 一个候选解 |
| 鸟的飞行速度 | 移动方向与步长 |
| 这只鸟记忆里食物最多的地方 | 个体历史最优 |
| 全群通报的食物最多的地方 | 群体历史最优 |
| 继续原来的飞行方向 | 惯性项 |
| 向自己最好的记忆靠近 | 认知项 |
| 向全群最好的记忆靠近 | 社会项 |
所以 PSO 不是「一只鸟爬山」,而是「一群鸟边飞边共享记忆」,用群体的合力把粒子「拽」向更优区域,同时靠随机与惯性保持探索。
数学原理
符号定义
| 符号 | 含义 |
|---|---|
| 第 | |
| 第 | |
| 第 | |
| 全体粒子的群体历史最优位置 | |
| 目标函数,本页最大化 | |
| 惯性权重, | |
| 个体认知 / 社会认知系数,通常 | |
| 每维独立抽取的 | |
| 速度分量上限,本页取 |
更新公式与参数含义
对每一维
三项的直觉:
- 惯性项
:保留上一代速度的比例。 大 → 全局探索强(大步飞行); 小 → 局部开发强(步子粘、易过早停滞)。常用策略是让 随迭代从约 0.9 线性降到约 0.4。 - 认知项
:把自己「拽」向个人最好点,鼓励个体差异化探索。 过大、 过小会退化成「各找各的」,难以共享信息。 - 社会项
:把全群「拽」向群体最好点,加速收敛。 过大、 过小会让全群过早涌向同一个点,失去多样性。
速度上限
与模拟退火的直觉对比
| 维度 | 模拟退火 SA | 粒子群优化 PSO |
|---|---|---|
| 灵感来源 | 金属退火(物理) | 鸟群/鱼群觅食(生物群体) |
| 基本单元 | 一个当前解 + 一个温度 | 一群粒子(各自位置 + 速度) |
| 跳出局部最优的机制 | 以概率 | 群体共享 gbest + 惯性飞行翻越局部峰 |
| 关键可调参数 | ||
| 并行性 | 单链(可多起点并行) | 天然并行(种群) |
| 记忆 | 只记一个 running best | 每个粒子记 pbest + 全局记 gbest |
为什么是近似解
PSO 的收敛由「惯性 + 认知 + 社会」三项合力的随机动力学决定,没有任何理论保证一定落到全局最优。它给出的是「迭代预算内找到的最好解」,可能停在局部峰(过早停滞)或还没爬完(迭代上限)。因此结论只能说「近似最优」,并用独立基准与多次运行统计来佐证。
收敛与停滞
- 收敛:随着粒子向 gbest 聚拢,
与 都趋于 ,速度逐渐衰减,粒子「抱团」在某个点附近,gbest 不再刷新。 - 停滞:若
太小、 失衡或种群多样性不足,粒子会过早抱团在一个局部峰,之后 gbest 长期无改进——这是 PSO 最典型的失败模式。诊断信号:连续多帧 gbest 不变(本文取「最近 20 帧无改进」)。
边界处理陷阱
速度更新可能把粒子推出可行域,必须显式处理。常见做法有「裁剪到边界并把该维速度置零」(本文实现,防止反复撞墙)或「反弹(速度取反)」。若不做边界处理,粒子会飞出去、目标函数可能在定义域外无意义或发散——这是 PSO 最常见的实现错误,详见「代码实践」的常见错误。
动态实验
迭代 0/100gbest.f = 7.0048x = -0.0736y = 1.8541惯性权重 w = 0.72最近改进 97 次迭代
初始化:20 个粒子随机散布在 [−3,3]²,速度在 ±vmax(=1.2)内随机,选出初始群体最优 gbest.f ≈ 7.005。
1 / 101
本演示最大化 MathWorks peaks 函数(
参数含义:
| 参数 | 范围 | 默认 | 作用 |
|---|---|---|---|
| 粒子数 | 10–40 | 20 | 种群规模;越多探索越充分、越慢 |
| 0.3–0.9 | 0.72 | 保留旧速度的比例;越小越粘、越易早停 | |
| 0.5–2.0 | 1.49 | 向 pbest 靠拢的力度 | |
| 0.5–2.0 | 1.49 | 向 gbest 靠拢的力度 | |
| seed | 42 / 7 / 123 | 42 | 随机种子;同一 seed 轨迹可复现 |
默认参数(seed 42)实测数值(与 Python 算例逐位一致):
| 项目 | 值 |
|---|---|
| 独立网格搜索(200×200)最优 | |
| seed 42 的 gbest 位置 | |
| seed 42 的 gbest.f | |
| seed 42 的 stallIterations | 3 |
多 seed(42 / 7 / 123)的 gbest.f 分别约
慢收敛 / 停滞对照(seed 42 实测):
| 配置 | gbest.f | stallIterations | 观察 |
|---|---|---|---|
| 默认 | ≈8.1062 | 3 | 快速收敛,最后 3 帧无改进 |
| 低惯性 | ≈8.1062 | 60 | 第 40 次迭代后 gbest 就不再改进(过早停滞) |
| 弱认知+弱社会 | ≈8.1062 | 0 | 100 次迭代结束时仍在改进(收敛慢,接近「迭代上限」) |
注意 peaks 对 PSO 而言较容易:在上述参数范围内三组固定种子的运行都到达同一高值区域(徽章多为「收敛」)。「停滞」「达到迭代上限」两种状态用于诊断更难的问题或更差的参数组合。粒子群优化是群体智能启发式:结果是近似解、依赖随机种子,需多次运行统计,不保证严格全局最优。
代码实践
完整代码
下面的代码与仓库 examples/pso.py 逐字一致,可用 python examples/pso.py 直接运行。脚本用独立网格搜索给出参考最优,复现默认参数与多 seed 的结果,并用 assert 与前端 TS 测试的钉死值交叉核对(不一致即非零退出)。
py
# -*- coding: utf-8 -*-
"""粒子群优化(PSO,最大化)—— MathModel FAQ 可运行算例。

目标函数(搜索域 [−3, 3]²,最大化)为 MathWorks peaks 函数:

    f(x,y) = 3(1−x)²·e^(−x²−(y+1)²) − 10(x/5 − x³ − y⁵)·e^(−x²−y²)
             − (1/3)·e^(−(x+1)²−y²)

这是一个多峰函数:在 [−3,3]² 内高值基准约为 8.1062(位于
(x,y) ≈ (−0.009, 1.581)),以及若干局部极大与一个深谷(约 −6.55)。
粒子群优化的更新公式(每维独立):

    v_d ← w·v_d + c1·r1·(pbest_d − x_d) + c2·r2·(gbest_d − x_d)
    x_d ← x_d + v_d

其中 r1、r2 为每迭代、每维独立抽取的 U(0,1);速度分量裁剪到 [−vmax, vmax],
vmax = 0.2·(b − a);位置越界时裁剪到边界并把该维速度置零。

随机数:mulberry32(seed),与前端 TS 引擎 docs/.vitepress/theme/math/pso.ts
逐位一致(32 位无符号运算,返回 [0,1) 的 IEEE 754 双精度浮点数)。同一 seed
得到逐位相同的轨迹,不同 seed 轨迹不同。参考最优值由独立网格搜索(200×200,
步长 0.03)给出,与 PSO 代码路径无关。

运行方式(本机实测:Python 3.14.8 + numpy 2.5.3 + matplotlib 3.11.2):
    python examples/pso.py

输出:控制台数值表 + docs/public/examples/pso-demo.png(matplotlib contour
等高线为真实函数值;注意与 Web 组件 PsoAnimation.vue 中的「网格色块近似」不同,
后者只是函数值的分块近似,粒子仍按真实 f 计算)。
"""
import math
import sys
from pathlib import Path

import matplotlib
# Agg 保存网页 PNG,无需图形桌面。NumPy 用于地形采样,随机流由下文的生成器提供。
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

ROOT = Path(__file__).resolve().parent.parent
OUT_DIR = ROOT / 'docs' / 'public' / 'examples'

BOUNDS = (-3.0, 3.0)

# 与前端 TS 测试钉死值一致(本机实测 Python 3.14.8;来源见 tests/pso.test.ts
# 与下文独立 200×200 网格搜索)。
SEED42_GBEST_X = -0.009317061786476257
SEED42_GBEST_Y = 1.5813688321287818
SEED42_GBEST_F = 8.106213589428114
SEED42_STALL = 3
GRID_F = 8.10434082784975


def mulberry32(seed):
    """mulberry32 确定性 PRNG;与前端 TS 实现逐位一致。"""
    state = seed & 0xFFFFFFFF

    def next_float():
        nonlocal state
        state = (state + 0x6D2B79F5) & 0xFFFFFFFF
        # t = Math.imul(a ^ (a >>> 15), 1 | a)
        t = ((state ^ (state >> 15)) & 0xFFFFFFFF) * (state | 1) & 0xFFFFFFFF
        # t = (t + Math.imul(t ^ (t >>> 7), 61 | t)) ^ t
        u = (t ^ (t >> 7)) & 0xFFFFFFFF
        w = u * (t | 61) & 0xFFFFFFFF
        t = (((t + w) & 0xFFFFFFFF) ^ t) & 0xFFFFFFFF
        # return ((t ^ (t >>> 14)) >>> 0) / 4294967296
        return ((t ^ (t >> 14)) & 0xFFFFFFFF) / 4294967296.0

    return next_float


def peaks(x, y):
    """目标函数(最大化):MathWorks peaks。乘号显式展开,保证与 TS 逐位一致。"""
    x2 = x * x
    y2 = y * y
    y1 = y + 1.0
    x1 = x + 1.0
    omx = 1.0 - x
    return (
        3.0 * omx * omx * math.exp(-x2 - y1 * y1)
        - 10.0 * (x / 5.0 - x * x * x - y * y * y * y * y) * math.exp(-x2 - y2)
        - (1.0 / 3.0) * math.exp(-x1 * x1 - y2)
    )


def run_pso(particles, iterations, w, c1, c2, bounds, seed, objective=peaks):
    """粒子群优化(最大化)。返回 {trajectory, gbest, stall_iterations}。

    trajectory 为 iterations+1 个 {iteration, positions, pbest, gbest} 帧,
    与 TS 引擎逐字段对应。随机数调用顺序(与 TS 完全一致,保证逐位一致):
      初始化:对每个粒子依次抽 4 次 —— x、y、vx、vy。
      每迭代:对每个粒子依次抽 4 次 —— r1x、r2x、r1y、r2y。
    """
    a, b = bounds
    rng = mulberry32(seed)
    # 每坐标最大速度为区间宽度的 20%,限制单步移动距离。
    vmax = 0.2 * (b - a)
    span = b - a

    positions = []  # 每个粒子 [x, y, vx, vy, f]
    pbests = []     # 每个粒子个体最优 [x, y, f]
    for _ in range(particles):
        x = a + rng() * span
        y = a + rng() * span
        vx = (rng() * 2.0 - 1.0) * vmax
        vy = (rng() * 2.0 - 1.0) * vmax
        f = objective(x, y)
        positions.append([x, y, vx, vy, f])
        pbests.append([x, y, f])

    # 扫描初始群体,记录第一次位置更新前的全局最优。
    gbest = [positions[0][0], positions[0][1], positions[0][4]]
    for p in positions:
        if p[4] > gbest[2]:
            gbest = [p[0], p[1], p[4]]

    # 复制当前位置和个体记忆,后续就地更新不会修改已记录的动画帧。
    def snapshot(iteration):
        return {
            'iteration': iteration,
            'positions': [list(p) for p in positions],
            'pbest': [list(b) for b in pbests],
            'gbest': list(gbest),
        }

    trajectory = [snapshot(0)]
    last_improve = 0

    # 网页采用逐粒子更新:某粒子刷新 gbest 后,同代的下一粒子即用新 gbest。
    for iteration in range(1, iterations + 1):
        for i in range(particles):
            p = positions[i]
            pb = pbests[i]

            # 惯性保留原方向,个体和群体项把坐标向相应历史最优点拉动。两轴独立抽样。
            r1x = rng()
            r2x = rng()
            vx = w * p[2] + c1 * r1x * (pb[0] - p[0]) + c2 * r2x * (gbest[0] - p[0])
            vx = min(max(vx, -vmax), vmax)

            r1y = rng()
            r2y = rng()
            vy = w * p[3] + c1 * r1y * (pb[1] - p[1]) + c2 * r2y * (gbest[1] - p[1])
            vy = min(max(vy, -vmax), vmax)

            x = p[0] + vx
            y = p[1] + vy
            # 越界:裁剪到边界并把该维速度置零。
            if x < a:
                x = a
                vx = 0.0
            elif x > b:
                x = b
                vx = 0.0
            if y < a:
                y = a
                vy = 0.0
            elif y > b:
                y = b
                vy = 0.0

            f = objective(x, y)
            p[0] = x
            p[1] = y
            p[2] = vx
            p[3] = vy
            p[4] = f

            # 只在严格提高时更新记忆,last_improve 记群体最近一次提升的迭代号。
            if f > pb[2]:
                pb[0] = x
                pb[1] = y
                pb[2] = f
            if f > gbest[2]:
                gbest = [x, y, f]
                last_improve = iteration

        trajectory.append(snapshot(iteration))

    return {
        'trajectory': trajectory,
        'gbest': {'x': gbest[0], 'y': gbest[1], 'f': gbest[2]},
        'stall_iterations': iterations - last_improve,
    }


def grid_search(bounds=BOUNDS, divisions=200):
    """独立网格搜索参考最优值(200×200,步长 0.03),与 PSO 代码路径无关。"""
    a, b = bounds
    best = {'x': a, 'y': a, 'f': peaks(a, a)}
    # divisions 为每轴等分数,含两个端点,因此每轴有 divisions+1 个采样位置。
    for i in range(divisions + 1):
        x = a + (b - a) * i / divisions
        for j in range(divisions + 1):
            y = a + (b - a) * j / divisions
            f = peaks(x, y)
            if f > best['f']:
                best = {'x': x, 'y': y, 'f': f}
    return best


def run_default():
    print('== 默认参数(seed 42,20 粒子,100 迭代,w=0.72,c1=c2=1.49)==')
    result = run_pso(20, 100, 0.72, 1.49, 1.49, BOUNDS, 42)
    gbest = result['gbest']
    print(f'  gbest.x = {gbest["x"]:.15f}')
    print(f'  gbest.y = {gbest["y"]:.15f}')
    print(f'  gbest.f = {gbest["f"]:.15f}')
    print(f'  stallIterations = {result["stall_iterations"]}')
    return result


def run_seeds():
    print('== 不同 seed 对比(同一默认参数,轨迹不同)==')
    rows = []
    for seed in (42, 7, 123):
        result = run_pso(20, 100, 0.72, 1.49, 1.49, BOUNDS, seed)
        gbest = result['gbest']
        print(f'  seed={seed}: gbest.x={gbest["x"]:.12f}, gbest.y={gbest["y"]:.12f}, '
              f'gbest.f={gbest["f"]:.12f}, stall={result["stall_iterations"]}')
        rows.append((seed, result))
    return rows


def make_figure(default_result, seed_rows, grid):
    OUT_DIR.mkdir(parents=True, exist_ok=True)
    a, b = BOUNDS
    xs = np.linspace(a, b, 400)
    ys = np.linspace(a, b, 400)
    X, Y = np.meshgrid(xs, ys)
    # Z 第 j 行、第 i 列是 (xs[i],ys[j]) 的目标,与坐标网格逐点对应。
    Z = np.array([[peaks(float(x), float(y)) for x in xs] for y in ys])

    fig, axes = plt.subplots(1, 2, figsize=(12.5, 5.6), dpi=110)

    ax = axes[0]
    cs = ax.contourf(X, Y, Z, levels=24, cmap='viridis')
    ax.contour(X, Y, Z, levels=24, colors='white', linewidths=0.3, alpha=0.5)
    fig.colorbar(cs, ax=ax, label='f(x, y)(真实函数值)')

    # 同一地形叠放初始与最终坐标以及每轮历史最优坐标。
    traj = default_result['trajectory']
    gx = [frame['gbest'][0] for frame in traj]
    gy = [frame['gbest'][1] for frame in traj]
    ax.plot(gx, gy, color='#c0392b', lw=1.6, zorder=4, label='gbest 轨迹')
    init_pos = traj[0]['positions']
    final_pos = traj[-1]['positions']
    ax.scatter([p[0] for p in init_pos], [p[1] for p in init_pos], s=14,
               color='#555555', zorder=3, label='初始粒子')
    ax.scatter([p[0] for p in final_pos], [p[1] for p in final_pos], s=22,
               facecolors='none', edgecolors='#1f8a4c', linewidths=0.8, zorder=4,
               label='最终粒子')
    g = default_result['gbest']
    ax.scatter([g['x']], [g['y']], marker='*', s=260, color='#e0a020', zorder=5,
               label=f"gbest f={g['f']:.3f}")
    ax.scatter([grid['x']], [grid['y']], marker='x', s=70, color='white', zorder=5,
               label=f'网格最优 f={grid["f"]:.3f}')
    ax.set_xlim(a, b)
    ax.set_ylim(a, b)
    ax.set_xlabel('x')
    ax.set_ylabel('y')
    ax.set_title('peaks 等高线 + 粒子轨迹(seed 42)')
    ax.legend(frameon=False, fontsize=8, loc='upper left')

    ax = axes[1]
    # 右图只改变随机种子,历史最优曲线的水平段代表连续多步未改进。
    for seed, result in seed_rows:
        traj = result['trajectory']
        bests = [frame['gbest'][2] for frame in traj]
        ax.plot(range(len(traj)), bests, lw=1.6, label=f'seed={seed}')
    ax.axhline(grid['f'], color='#b07d2b', lw=1, ls='--',
               label=f'网格最优 {grid["f"]:.4f}')
    ax.set_xlabel('迭代次数')
    ax.set_ylabel('gbest.f(群体最优)')
    ax.set_title('收敛曲线 gbest.f vs 迭代')
    ax.grid(alpha=0.25)
    ax.legend(frameon=False, fontsize=8)

    fig.tight_layout()
    fig.savefig(OUT_DIR / 'pso-demo.png')
    plt.close(fig)
    print(f'== 绘图已保存到 {OUT_DIR / "pso-demo.png"} ==')


def main() -> None:
    print('== 环境 ==')
    print(f'  Python {sys.version.split()[0]}')
    print(f'  numpy {np.__version__}, matplotlib {matplotlib.__version__}')
    grid = grid_search()
    print('== 独立网格搜索(200×200,步长 0.03)==')
    print(f'  网格最优 x = {grid["x"]:.15f}')
    print(f'  网格最优 y = {grid["y"]:.15f}')
    print(f'  网格最优 f = {grid["f"]:.15f}')
    print('  (注:peaks 本例高值基准约 8.1062,位于 ≈(−0.009, 1.581),网格分辨率 0.03 只能逼近)')
    default_result = run_default()
    seed_rows = run_seeds()
    make_figure(default_result, seed_rows, grid)

    # —— 与前端 TS 测试钉死值交叉核对(容差 1e-9;stall 为整数应精确相等)——
    print('== 与 TS 测试钉死值交叉核对 ==')
    g = default_result['gbest']
    assert abs(g['x'] - SEED42_GBEST_X) < 1e-9, 'gbest.x 与 TS 钉死值不一致'
    assert abs(g['y'] - SEED42_GBEST_Y) < 1e-9, 'gbest.y 与 TS 钉死值不一致'
    assert abs(g['f'] - SEED42_GBEST_F) < 1e-9, 'gbest.f 与 TS 钉死值不一致'
    assert default_result['stall_iterations'] == SEED42_STALL, 'stallIterations 与 TS 钉死值不一致'
    assert abs(grid['f'] - GRID_F) < 1e-9, '网格最优 f 与 TS 钉死值不一致'
    print('  全部交叉核对通过')
    print('== 全部断言通过 ==')


if __name__ == '__main__':
    main()
运行方式
bash
cd mathmodel-faq
pip install -r examples/requirements.txt   # numpy / matplotlib(本算例仅用这两个)
python examples/pso.py
依赖列表见仓库 examples/requirements.txt(本算例只用 numpy 与 matplotlib)。本机实测环境:Python 3.14.8、numpy 2.5.3、matplotlib 3.11.2。脚本不联网、不用付费 API;任何一条断言失败都会以非零退出码退出。
输出结果(本机实际运行)
text
== 环境 ==
  Python 3.14.8
  numpy 2.5.3, matplotlib 3.11.2
== 独立网格搜索(200×200,步长 0.03)==
  网格最优 x = 0.000000000000000
  网格最优 y = 1.590000000000000
  网格最优 f = 8.104340827849750
  (注:peaks 本例高值基准约 8.1062,位于 ≈(−0.009, 1.581),网格分辨率 0.03 只能逼近)
== 默认参数(seed 42,20 粒子,100 迭代,w=0.72,c1=c2=1.49)==
  gbest.x = -0.009317061786476
  gbest.y = 1.581368832128782
  gbest.f = 8.106213589428114
  stallIterations = 3
== 不同 seed 对比(同一默认参数,轨迹不同)==
  seed=42: gbest.x=-0.009317061786, gbest.y=1.581368832129, gbest.f=8.106213589428, stall=3
  seed=7: gbest.x=-0.009317939600, gbest.y=1.581367683280, gbest.f=8.106213589440, stall=14
  seed=123: gbest.x=-0.009317730591, gbest.y=1.581367741332, gbest.f=8.106213589441, stall=2
== 绘图已保存到 …docs\public\examples\pso-demo.png ==
== 与 TS 测试钉死值交叉核对 ==
  全部交叉核对通过
== 全部断言通过 ==
结果图
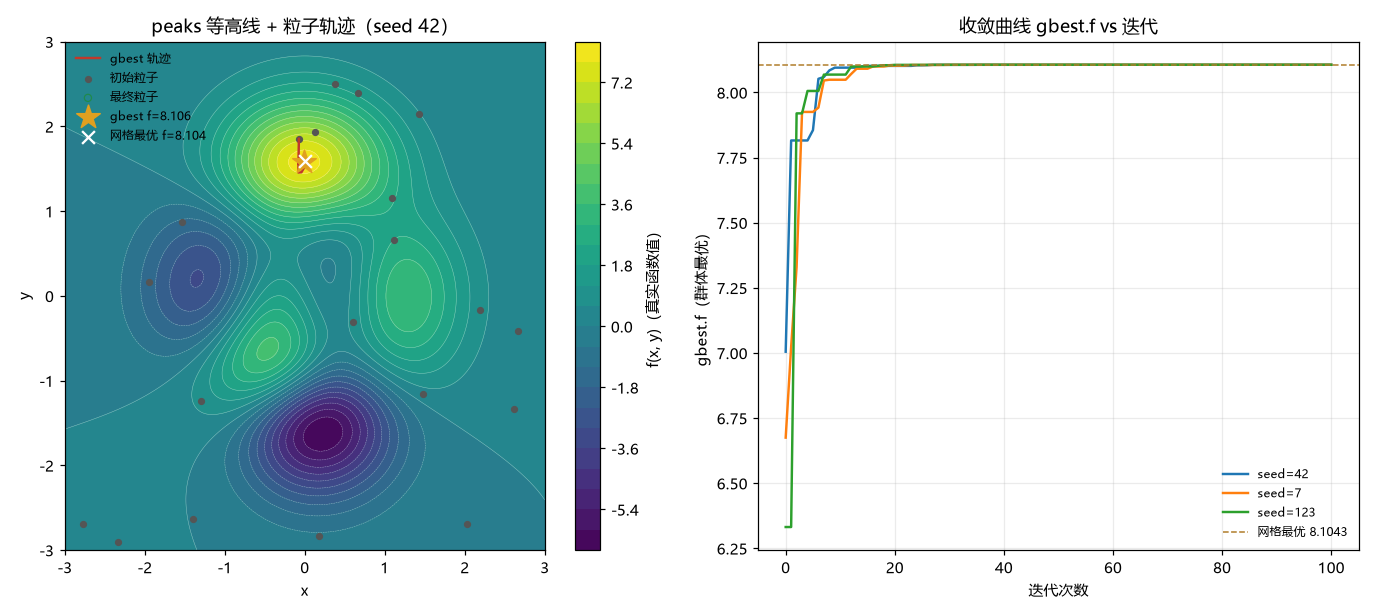
左图为 matplotlib contourf/contour 的真实等高线(函数值的精确表示),与 Web 组件 PsoAnimation.vue 中的「网格色块近似」不同;右图为 gbest.f 随迭代的收敛曲线,虚线是 200×200 网格搜索的参考最优。
关键参数
| 参数 | 含义 | 本算例取值与效果 |
|---|---|---|
| 保留旧速度的比例 | 0.72 快速收敛;降到 0.3 过早停滞 | |
| 向 pbest 靠拢的力度 | 1.49 与 | |
| 向 gbest 靠拢的力度 | 1.49 与 | |
| 粒子数 | 种群规模 | 默认 20 个粒子、100 次迭代。比较不同随机种子的最优值与停滞情况 |
| 速度上限 | ||
| seed | 随机种子 | 42 / 7 / 123 得到不同轨迹、相同的最优 |
常见错误
- 无边界处理:速度更新可能把粒子推出可行域,若不裁剪/反弹,目标函数可能在定义域外无意义或发散。务必显式处理越界(优化算法无法收敛怎么办)。
- 单次运行当结论:PSO 是随机启发式,单次 gbest 只是随机变量的一个实现。应多 seed 统计分布,并与独立基准(网格搜索/枚举)核对(多次运行得到不同结果怎么办)。
- 随机不设种子:不固定 seed 时每次轨迹不同、结果不可复现。固定 seed 并记录进报告(代码能够运行,但结果无法复现怎么办)。
- 参数随意:
太小过早停滞、 失衡失去多样性、 过大发散。应从默认值出发,观察收敛曲线调参。 - 把近似当最优:PSO 没有全局最优保证,只能说「近似最优」,不要宣称「证明了全局最优」。
专业速查
假设
| 假设 | 说明 |
|---|---|
| 变量连续 | 位置在连续空间内更新;离散问题需先设计编码 |
| 可行域为盒约束 | 每维一个区间 |
| 目标可评估 | 每个粒子每代都要计算 |
| 群体多样性足够 | 初始粒子尽量覆盖搜索域,避免一开始就抱团 |
| 随机源可复现 | 用确定性 PRNG(固定 seed)便于复现 |
参数
| 参数 | 建议 |
|---|---|
| 粒子数 | 10–50 常见;维数越高、问题越难越需要更多 |
| 0.4–0.9;常用线性衰减(0.9 → 0.4)平衡探索与开发 | |
| 常取 | |
| 取搜索域宽度的一个比例(如 10%–20%),防发散 | |
| 停止条件 | 固定迭代次数,或 gbest 连续多代无改进(停滞) |
复杂度与优缺点
| 维度 | 内容 |
|---|---|
| 时间复杂度 | |
| 空间复杂度 | 只存当前种群为 |
| 优点 | 实现简单、天然并行、几乎不依赖目标光滑性、收敛快 |
| 缺点 | 无全局最优保证、易过早停滞、对参数敏感、离散/约束问题需额外处理 |
指标
| 指标 | 说明 |
|---|---|
| gbest.f | 群体历史最优目标值,是最终交付的「解」 |
| gbest.x / gbest.y | 最优解的位置(本页二维) |
| stallIterations | 自最后一次 gbest 改进以来的迭代数,越大越接近停滞 |
| 收敛曲线 | gbest.f vs 迭代,观察是否还在改进 |
| 多次运行分布 | 多 seed 的 gbest.f 均值/最差,衡量稳定性 |
高频问题(FAQ)
| 问题 | 回答 |
|---|---|
| PSO 和模拟退火有什么区别? | 机制不同:SA 靠接受劣解跳出局部最优,PSO 靠群体记忆 + 惯性飞行;PSO 天然并行 |
| 从 | |
| PSO 一定能找到全局最优吗? | 不能保证;可能过早停滞或迭代不足,只能给近似解 |
| 最小化问题怎么用? | 对目标取负(或把比较符号反过来) |
| 粒子飞出边界怎么办? | 必须显式处理:裁剪到边界并把速度置零(或反弹) |
| 为什么结果每次不一样? |
双语言实验
沿用上面 peaks 的有界最大化问题。这组程序用 12 个粒子运行 60 次更新,固定初始位置、随机系数生成规则和初始速度(全零),只比较惯性权重
从位置差理解群体收缩
如果粒子正好位于它的个人最优点,认知项为零。这包括初始时刻,所以第一轮都只受社会项作用。只要它与群体历史最佳点还有距离,社会项就会拉动它。上一轮留下的速度通过
运行原理实现
- Python 环境安装
python -m pip install numpy matplotlib后,在下载目录运行python mmf_pso.py。 - MATLAB 在下载目录运行
result = mmf_pso(),使用基础 MATLAB 的peaks、yyaxis和隐式扩展,建议 R2016b 或更新版本,无需工具箱。
固定两个粒子的初始位置、速度与两轮随机系数,逐步使用惯性、个体最优和全局最优三项。最佳位置记忆到达 2,目标值为 0,粒子的最终位置与历史最好点可以不同。
最简版依赖 Python:NumPy。MATLAB:基础功能,无需额外工具箱。
在源码所在目录运行 python mmf_min_pso.py
py
下载当前源码import json
import numpy as np
x = np.array([0., 4.])
velocity = np.array([1., 0.])
personal = x.copy()
objective = lambda values: (values - 2) ** 2
global_best = personal[np.argmin(objective(personal))]
history = [float(global_best)]
# 两轮同步更新;用约定的 r1、r2 演示速度公式,便于手算与复核。
for r1, r2 in [(.5, .5), (.5, .5)]:
velocity = .5 * velocity + r1 * (personal - x) + r2 * (global_best - x)
x = x + velocity
better = objective(x) < objective(personal)
personal[better] = x[better]
global_best = personal[np.argmin(objective(personal))]
history.append(float(global_best))
best_value = float(objective(global_best))
assert np.allclose(history, [0, 2, 2]) and best_value == 0
result = {"best_positions": history, "final_positions": x.tolist(), "best_value": best_value}
print("LAB_RESULT " + json.dumps(result, ensure_ascii=False))两种语言都用同一整数递推产生均匀系数。Python 按行重排数组,MATLAB 在列优先的 reshape 后转置,得到相同的“每粒子一行、每坐标一列”。Python 用 np.clip 限制速度和位置,MATLAB 用 min(max(...))。比较初始目标、历史最佳曲线、最终半径和越界分量计数。有限网格参考值约 particleswarm 需要 Global Optimization Toolbox,调用时最小化
参数练习
看两个权重的第一步是否相同。到第 60 步时,对比它们的历史最佳值与半径。能否仅凭粒子非常聚拢,就判断它找到了全局最优?
参考答案
两组第一步相同,因为此时惯性速度是零。权重